 Jan Montag
600 GB Musik, mein Raspberry Pi und der Gaming-PC :)
Wie AudioMuse-AI meine Navidrome-Bibliothek in zwei Tagen sortiert hat 1
Hi, ich habe mir ja vor geraumer Zeit, aufbauend auf meine kleine, digitale Musikaliensammlung, einen Navidrome Server (Was?) installiert und streame fortan meine eigene Musik an mich selbst 2. Oder an andere Geräte. Das fetzt, denn dadurch werde ich unabhängig(er) von Spotify 3. Allerding gibt es da ein paar Abstriche zu machen. Zum Beispiel hat Spotify eine coole Funktion, ähnlich passende Songs weiter zu spielen, die man unter Umständen gar nicht kennt, wenn man das Ende einer Playlist erreicht hat oder nach einem Einzelsong. Und noch viele weitere nützliche Features, die man erst zu schätzen weiß, wenn sie weg sind.
Nun verfüge ich auch über eine recht große Sammlung und könnte mir vorstellen, mit so einem Vorschlags-Feature vor allem mich selbst überraschen zu können. In dem da Musik aus meiner eigenen Bibliothek gespielt wird, die ich gar nicht eingeordnet hätte. Das finde ich total spannend.
Navidrome ist bei mir also seit geraumer Zeit der ruhige, unaufgeregte Teil meines kleines Heimnetzwerks: Musik liegt auf einer USB-Festplatte, der Pi liefert sie aus und die Apps sind zufrieden. Was Navidrome aber nicht kann, ist die Frage zu beantworten, die mich wie oben beschrien ziemlich interessiert:
Welche 40 Lieder passen eigentlich zu diesem einen Lied?
oder
Spiel entsprechend des Songs einfach immer weiter…
Und damit meine ich nicht “gleicher Interpret” oder nicht “gleiches Genre”– sondern: gleicher Puls, gleiche Energie, gleiche Stimmung. Genau dafür gibt es AudioMuse-AI. Und genau dafür habe ich mir fast vier Wochen Rechenzeit eingehandelt, die ich am Ende auf zwei Tage drücken konnte.
Dieser Artikel ist beides: eine Einordnung, was AudioMuse-AI eigentlich macht, und ein kleiner Erfahrungsbericht über die Skalierung – inklusive der Stellen, an denen ich falsch geraten habe.
Was also ist AudioMuse-AI?
AudioMuse-AI ist ein selbstgehostetes, quelloffenes Werkzeug, das die eigene Musiksammlung klanglich analysiert und daraus Playlists baut. Der entscheidende Punkt: Es geht nicht über Metadaten. Kein Genre-Tag, kein “similar artist” aus einer Online-Datenbank, keine externen APIs für den Kern der Analyse. Es hört sich die Dateien an.
Dabei entsteht pro Titel kein “Tag”, sondern eine Sammlung von Vektoren:
- MusiCNN erzeugt ein 200-dimensionales Embedding aus Mel-Spektrogramm-Patches – der klangliche Fingerabdruck eines Titels. - Dasselbe Modell liefert Mood-Wahrscheinlichkeiten für Labels wie rock, blues, indie. - DCLAP (ein CLAP-Modell) erzeugt ein 512-dimensionales Audio-Embedding, mit dem sich auch Text und Musik vergleichen lassen – daraus entstehen die sechs Zusatzwerte danceable, aggressive, happy, party, relaxed, sad. - Die Lyrics-Stufe erzeugt ein 768-dimensionales Text-Embedding (mehrsprachig, ohne Übersetzungsschritt) plus 27 Achsenwerte wie Setting, soziale Dynamik, emotionale Valenz. - Dazu kommen Tempo, Energie, Tonart und ein Chromaprint-Fingerabdruck zur Duplikaterkennung.
Alles landet in PostgreSQL. In den Musikdateien selbst wird nichts verändert, und die Track-IDs bleiben die von Navidrome – AudioMuse ist also ein zustäzlicher Player, kein Umzug.
Aus diesen Vektoren entstehen dann z.B. folgende Features, die ich eben als nützlich erachte:
| Feature | Was es tut |
|---|---|
| Clustering | Gruppiert die Bibliothek in Playlists, die klanglich zusammenpassen – Genre-Grenzen ignoriert das absichtlich |
| Instant Playlist | “High-Tempo, low-Energy, aber fröhlich” – ein LLM übersetzt das in echte Datenbankabfragen |
| Music Map | Die Sammlung als zweidimensionale Landkarte, in der Nachbarschaft tatsächlich Ähnlichkeit bedeutet |
| Playlist from Similar Songs | Ein Lieblingslied auswählen, den Rest findet die Software |
| Song Path | Eine Hörreise zwischen zwei Titeln, die klanglich keine Sprünge macht |
| Song Alchemy | Titel als “add” oder “subtract” markieren, Vibe mischen, Ergebnis direkt in den Medienserver exportieren |
| Text Search | “ruhiges Klavier” finden, ohne dass das Tag “Klavier” existiert |
| Lyrics Search | Nach Bedeutung suchen: Liebeslieder, Abschied, politische Texte |
| Search by Recording | 20 Sekunden Handy-Aufnahme hochladen, Titel in der eigenen Sammlung finden |
| Sonic Fingerprint | Playlists nach dem eigenen Hörverhalten |
All die Punkte die ich mir eingangs wünschen würde, um ein echtes Spotify für meine eigene kleine Bibliothek zu erhalten, die rüstet mir das System nach.
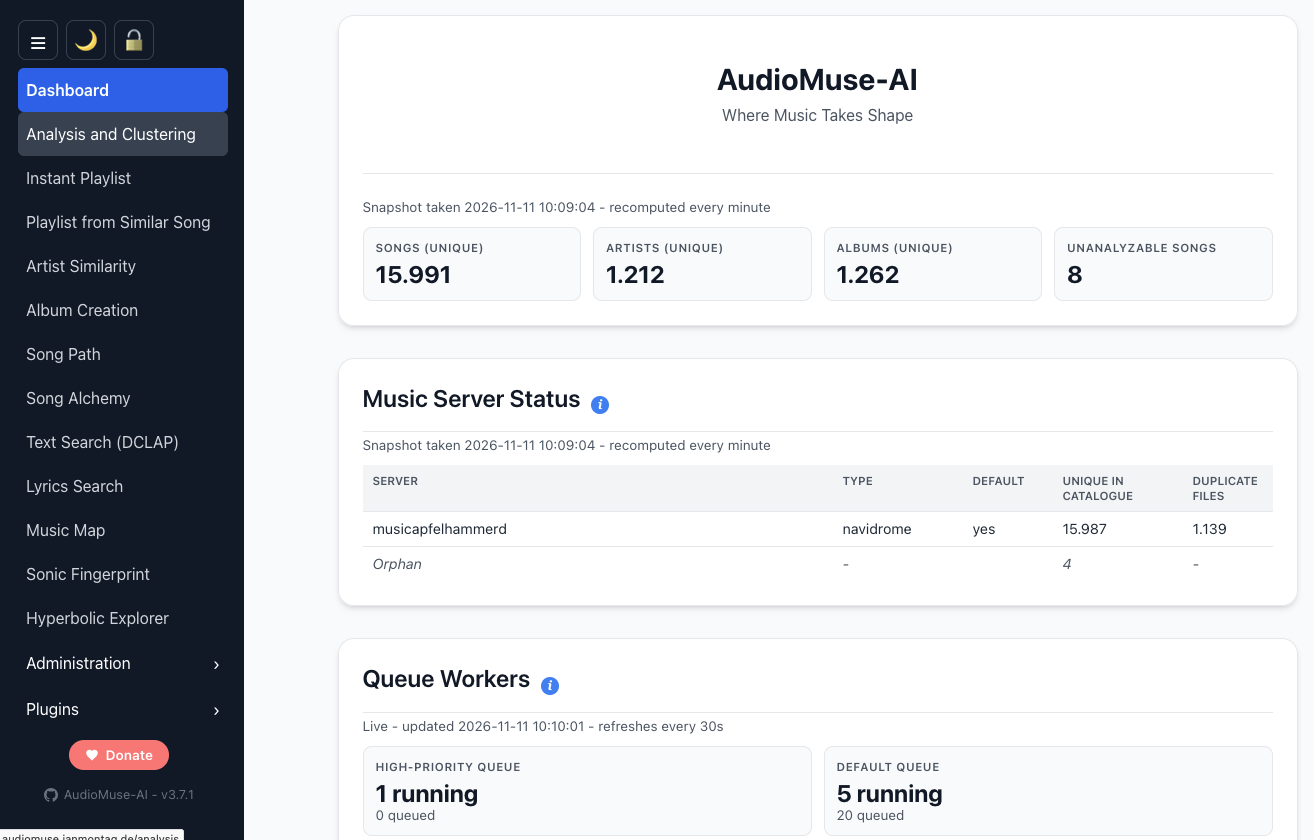 Bild dient der Dekoration. Zu sehen ist das Webinterface von Audiomuse, das Dashboard. 15000 Titel sind bereits analysiert worden.
Warum das, wenn ich doch Navidrome habe?
Das ist die naheliegende Frage, und die Antwort ist: Die beiden konkurrieren nicht, sie sind komplementär.
Navidrome ist ein Verteiler. Es weiß, welche Datei zu welchem Titel gehört, wer sie hören darf und wie sie heißt. Es ist schnell, es ist wartungsarm, es funktioniert auf jedem Client. Was es nicht hat, ist ein Verständnis davon, wie Musik klingt. Navidrome kann dir sagen: gleicher Künstler, gleiches Album, gleiches Genre-Tag. Es kann dir nicht sagen: das hier hat denselben Puls wie jenes, obwohl das eine Trip-Hop und das andere Fusion-Jazz ist.
AudioMuse ist umgekehrt ein Analyst. Es hat kein Interesse daran, Musik auszuliefern – es hat nicht mal eine eigene Player-Oberfläche, die man ernsthaft benutzen würde. Es rechnet, speichert Vektoren und schreibt fertige Playlists zurück.
Die Arbeitsteilung ist also:
Navidrome  →  hält die Dateien, kennt die IDs, liefert die Streams, spielt ab
AudioMuse  →  hört zu, rechnet, findet Ähnlichkeiten, schreibt Playlists
Konkret läuft das über die OpenSubsonic-API von Navidrome: AudioMuse fragt die Albenliste ab, lädt pro Titel den Stream herunter, analysiert ihn, wirft die Datei weg und schreibt am Ende Playlists zurück in Navidrome – die dann in jedem Subsonic-Client auftauchen, auf dem Handy genauso wie im Web. Für Navidrome gibt es zusätzlich ein eigenes Plugin, das die AudioMuse-Features direkt in die Oberfläche holt.
Der Preis dafür ist Rechenzeit. Und das ist der Punkt, an dem dieser Artikel interessant wird.
Die Menge von 600 GB auf einem Raspberry Pi
Meine Ausgangslage:
- Bibliothek: 7.533 Alben, rund 600 GB, auf einer externen Festplatte
- Server: Raspberry Pi 5 mit vier Kernen und 8 GB RAM, darauf Navidrome, PostgreSQL und der AudioMuse-Stack
- Software: AudioMuse-AI v3.7.1, offizielles Docker-Setup (Flask, Worker, PostgreSQL)
Die offizielle Mindestanforderung ist ein Vierkern-Prozessor (Intel mit AVX2 oder ARM) und 8 GB RAM – der Pi erfüllt das. Auf dem Papier. In der Praxis ist das Analysewerk der Flaschenhals: pro Titel werden mehrere ONNX-Modelle über ein Mel-Spektrogramm geschickt.
Nach ein paar Tagen Laufzeit ließ sich die Rate sauber messen: knapp 11 Alben pro Stunde. Bei 7.533 Alben sind das knapp vier Wochen. Interessant war, dass der Pi dabei nicht “am Limit” aussah. Die CPU war ausgelastet, aber die eigentliche Zeit fraß etwas anderes – wait for it: dazu gleich!
Was wirklich gebremst hat
Zwei Einstellungen waren für den Großteil der Laufzeit verantwortlich, und beide haben nichts mit roher Rechenleistung zu tun.
1. Whisper für Liedtexte. Die Lyrics-Stufe hat eine klare Reihenfolge: erst schauen, ob der Medienserver Lyrics mitliefert, dann eine optionale externe API, und nur wenn beides nichts liefert, transkribiert Whisper-small die Audiodatei. Das ist beeindruckend – und es ist wahnsinnig (Zeit)teuer: 50 bis 90 Sekunden pro Titel, einspännig, für einen einzigen Song.
In meiner Bibliothek liefert die API aber nur für gut die Hälfte der Titel etwas. Bei Instrumentalmusik, Hörspielen und Comedy-Alben findet sie naturgemäß nichts. Der Rest ging durch Whisper – und produzierte bei Instrumentalstücken teils halluzinierten Text. Im Log stand bei einem Lounge-Track irgendwann “Waiting for bus number 99”. Das ist nicht nur langsam, das ist Datenmüll.
Die Lösung war eine kleine Config-Änderung: LYRICS_ASR_ENABLE=false. Titel ohne gefundene Lyrics werden jetzt sauber als instrumental markiert (AudioMuse nennt das “instrumental sentinel”) und bleiben im Index. Ergebnis: 3 bis 5 Sekunden statt 60.
2. Modelle pro Song neu laden. Standardmäßig lädt AudioMuse die ONNX-Modelle zwischen Titeln neu – auf einer GPU sinnvoll, weil der Speicher knapp ist, auf einer CPU reine Verschwendung. Mit PER_SONG_MODEL_RELOAD=false fällt das weg.
Zusammen mit einer externen Lyrics-Quelle (LRCLIB) hat das die Rate auf dem Pi messbar verbessert – aber nicht gerettet. Vier Wochen bleiben vier Wochen, wenn die Hardware nicht mehr hergibt.
Der Umzug auf den zweiten PC
Der Gaming-PC daneben (Ryzen 5 7600X, 12 Threads, 16 GB RAM), bei dem wir die Grafikkarte leider nicht nutzen können, langweilte sich trotzdem die meiste Zeit. Die naheliegende Idee: Warum nicht die Analyse dorthin auslagern, ohne die Bibliothek anzufassen?
Genau dafür ist AudioMuse gebaut. Es gibt einen dokumentierten Remote-Worker-Modus: derselbe Docker-Image, aber mit SERVICE_TYPE=worker. Der Worker verbindet sich auf die PostgreSQL-Instanz des Masters, holt sich Album-Tasks aus der Queue, lädt die Audiodateien direkt vom Medienserver und schreibt die Ergebnisse zurück. Der Master bleibt der Master – die Web-Oberfläche, die Datenbank, der Fortschritt, alles unverändert.
Wichtig war: Die Musik bleibt, wo sie ist. Der PC lädt jeden Titel über HTTP von Navidrome, analysiert ihn im RAM bzw. im Container-Temp und löscht ihn wieder. Kein rsync, kein NFS, keine zweite Kopie der Sammlung.
Der Compose-Teil dafür ist überschaubar:
x-worker: &worker
  image: ghcr.io/neptunehub/audiomuse-ai:3.7.1   # gleiche Version wie der Master
  cpus: 3                                        # wichtig, siehe unten
  environment:
    SERVICE_TYPE: "worker"
    POSTGRES_HOST: "192.168.178.171"             # der Pi
    POSTGRES_PORT: "5432"
    POSTGRES_USER: "${POSTGRES_USER}"
    POSTGRES_PASSWORD: "${POSTGRES_PASSWORD}"
    POSTGRES_DB: "audiomusedb"
    TEMP_DIR: "/app/temp_audio"
  extra_hosts:
    # Navidrome ist in der DB als host.docker.internal hinterlegt
    - "host.docker.internal:192.168.178.171"
  restart: unless-stopped

services:
  worker-1:
    <<: *worker
    container_name: audiomuse-worker-pc-1
    volumes: ["temp-1:/app/temp_audio"]
  worker-2:
    <<: *worker
    container_name: audiomuse-worker-pc-2
    volumes: ["temp-2:/app/temp_audio"]

volumes:
  temp-1:
  temp-2:
Zwei Fallstricke, die mich Zeit gekostet haben:
Die CPU-Zahl ist nicht kosmetisch. Ohne cpus: liest jeder Container die Threads des Hosts – bei vier Workern auf einem 12-Thread-Rechner starten also 48 ONNX-Threads und behindern sich gegenseitig. AudioMuse bringt dafür eigens cpu_budget.py mit: Das Limit aus dem cgroup wird gelesen und die ONNX-Threads entsprechend gedeckelt. Mit cpus: 3 und vier Workern passt es exakt.
PostgreSQL hat ein Verbindungslimit. Jeder Worker hält einen eigenen Pool, rund 12 Verbindungen. Bei max_connections=100 ist nach fünf Workern plus Flask plus Pi-Worker Schluss – und die Fehlermeldung taucht dann im Dashboard als “database is unavailable” auf, obwohl die Datenbank völlig gesund ist. Ich habe die Datenbank nicht angefasst, sondern einen kleinen socat-Proxy-Container davorgesetzt, der nur den Port 5432 ins LAN veröffentlicht. Kein Neustart der DB, kein Risiko für den laufenden Analysefortschritt.
Skalierung ist nicht linear
Die ersten Messungen sahen so aus (jeweils über mehrere Minuten gemessen):
| Konfiguration | Alben pro Stunde | Hochgerechnet auf 7.533 Alben |
|---|---|---|
| Pi allein | 10,8 | ~29 Tage |
| 2 Worker am PC | ~54 | ~6 Tage |
3 Worker (cpus: 4) |
84 | ~3,7 Tage |
4 Worker (cpus: 3) |
106–144 | ~2–3 Tage |
| 5 Worker | ~133 | kein Mehrwert |
Der Sprung von 1 auf 2 Worker ist riesig, danach wird es zäh. Und beim fünften passiert gar nichts mehr – die Erklärung dafür ist der eigentliche Lernmoment des Projekts.
Die Zahlen stammen aus verschiedenen Messfenstern, weil sich zwischendurch das Netzwerk geändert hat. Entscheidend ist der Vergleich unter gleichen Bedingungen: Nach dem Umbau lag der Betrieb mit vier Workern bei 144 Alben/h, mit fünf Workern darunter. Mehr Container halfen nicht, weil inzwischen die Leitung limitierte und nicht die Rechenleistung.
Der Flaschenhals wandert
Man kann nicht einfach Worker dazustellen und hoffen. Der Engpass verschiebt sich mit jedem Schritt:
- Erst die CPU – der Pi rechnet, was er kann.
- Dann die Lyrics-Stufe – Whisper dominiert die Laufzeit, unabhängig von der Kernzahl.
- Dann das Netzwerk – und hier hat es mich erwischt.
Der PC hing per WLAN am Router. Der Pi lieferte konstant 4,4 MB/s Musik raus, das WLAN-Interface meldete eine Empfangsbitrate von 40 Mbit/s bei −66 dBm. Der Link war voll ausgelastet, die Worker warteten auf Bytes: Im Log vergingen zwischen “Analyzing track” und “Downloaded” regelmäßig 13 Sekunden, die Analyse selbst dauerte danach 3.
Ein Rohdurchsatz-Test mit nc bestätigte es: 100 MB brauchten 133 Sekunden, also etwa 0,75 MB/s – und das zusätzlich zu dem Traffic, den die Worker schon zogen.
Bei 600 GB Bibliothek ist das die entscheidende Zahl. Rund 480 GB waren zu diesem Zeitpunkt noch zu übertragen:
| Weg | Durchsatz | Reine Übertragungszeit für 480 GB |
|---|---|---|
| WLAN | ~4,4 MB/s | ~31 h |
| Powerline (Stromkabel) | ~1,7 MB/s | ~80 h |
| Summe beider Leitungen | ~6,1 MB/s | ~22 h |
Ich habe dann beide Leitungen gleichzeitig benutzt. Normalerweise ist Powerline nur das LAN für die Vintage Computer, denen reicht das. Weil es eben so lahm ist. Das geht unter Linux mit einer gewichteten Multipath-Route – nicht automatisch, aber mit einem Befehl:
ip route replace 192.168.178.171/32 \
  nexthop dev wlp7s0 weight 5 \
  nexthop dev enp8s0 weight 2
Der Kernel verteilt pro TCP-Verbindung (nicht pro Paket), jede Verbindung bleibt also auf einer Leitung. Das Internet läuft weiter über die Default-Route des WLANs; nur der Verkehr zum Musikserver wird aufgeteilt. In der Messung kamen danach 2,2 MB/s über WLAN und 0,9 MB/s über Powerline an – die Aufteilung funktionierte, und als das WLAN später auf 15 Mbit/s einbrach, trug das Stromkabel plötzlich 28 Prozent des Traffics. Es war also noch mal eingebrochen, fragt mich nicht welche Mikrowellen hier stören und warum das so stark schwankt, jetzt habe ich wieder stabile 12 Megabyte pro Sekunde übers WLan.
Wo ich jetzt gerade stehe
Nach dem ASR-Aus und mit vier Workern läuft die Analyse bei 144 Alben pro Stunde. Der Rest der 7.533 Alben ist damit in etwa anderthalb bis zwei Tagen durch – abhängig davon, wie gut das WLAN mitspielt, denn inzwischen ist wieder das Netzwerk der Engpass, nicht der Ryzen. Die Container dümpeln bei einem Drittel ihres CPU-Limits, während alle vier gleichzeitig auf Downloads warten.
Das ist insgesamt etwa 13-mal schneller als auf dem Pi allein. Das lohnt sich!
Ein paar Dinge, die ich dabei gelernt habe und die ich beim nächsten Mal anders machen würde:
- Messen, nicht raten. Jede “Optimierung” habe ich über mindestens zehn Minuten gegen den Albumzähler geprüft. Zwei davon haben sich als wirkungslos herausgestellt.
- Den Haupttask nicht anfassen. Der laufende Analyse-Job steht bei
attempts 3/3. Ein Neustart des Worker-Containers auf dem Master beendet die Orchestrierung endgültig – die bereits analysierten Daten bleiben, aber der Lauf müsste neu gestartet werden. - Worker vorsichtig stoppen. Album-Tasks haben
max_attempts=1. Ein hart abgeschossener Worker kostet das Album, das er gerade bearbeitet. Wenn man den PC zum Zocken braucht, sollte man höchstens einmal pro Album stoppen. - Erst den Engpass finden, dann skalieren. Der fünfte Worker war reine Verschwendung – nicht weil die Software schlecht skaliert, sondern weil die Leitung schon voll war.
Fazit
AudioMuse-AI ist kein Ersatz für Navidrome, sondern die Schicht, die Navidrome fehlt. Es ist erstaunlich, was aus einer gewachsenen Sammlung herausfällt, wenn man sie nicht nach Tags, sondern nach Klang sortiert: Übergänge, die man nie ausprobiert hätte, Nachbarschaften zwischen Genres, die es auf keinem Sampler gibt.
Der Preis ist Rechenzeit – und die falsch einzuschätzen ist der eigentliche Aufwand an der Sache. Auf einem Pi mit 600 GB Bibliothek ist die Analyse ein Projekt für Wochen. Mit einem zweiten Rechner, zwei, drei Config-Zeilen und etwas Geduld beim Netzwerk wird daraus ein Wochenende.
Und ganz ehrlich: Der Moment, als die erste automatisch generierte Playlist überaschend-anders klingt als die vorher mühsam erstellte Eigene, ist die (vier Wochen) Wartezeit fast wert. Man muss hier bedenken, dass der kleine Raspby ja sowieso immer läuft mit seinen wenigen Watt und Dinge bereit stellt, er also nebenbei rechnete.
Ressourcen
 TerminalDrome
 neptunehub.github.io
 HerrMontag.de
-
Transparenz: Die Analyse lief zum Zeitpunkt dieses Artikels noch; die Zahlen sind laufend gemessen, nicht nachträglich geschönt. Die IP-Adressen sind Beispielwerte. ↩︎
-
Hier habe ich mal aufgeschrieben, warum man Spotify meiden sollte. ↩︎