Last.fm kostenpflichtig: Scrobbler selber hosten!
Seit ungeföhr 2008 scrobble ich. Der erste Eintrag in meiner Last.fm-Historie ist vom 8. April 2008, 22:35 Uhr: Funny van Dannen – Lobdefizit. Seitdem hat sich eine Menge angesammelt – über 119.000 Einträge, aus Navidrome, aus Spotify, aus Jahren, in denen ich andere Player benutzt habe. Und dabei habe ich ab 2014 einen riesigen Gap. Wahrscheinlich, weil ich da keine Scrobble-Software mehr genutzt habe oder beim Sync des Telefons mit iTunes (das war früher der Moment, in welchem der last.fm-Scrobbler die Songs übertrug) nicht mehr darauf achtete… und andere familäre Verpflichtungen.
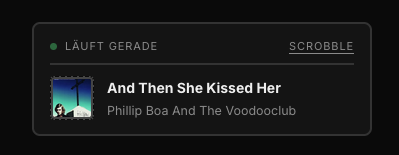
Und jetzt die Nachricht, die viele andere und ich gern hören wollten: Ab dem 1. Dezember 2026 ist die Last.fm-API nur noch für Pro-Abonnenten nutzbar. (Link) Ich nutze zwar die API gar nicht, um Musik zu hören. Ich nutze sie aber für ein kleines Widget im Footer dieses Blogs, das den aktuellen oder zuletzt gespielten Song anzeigt. Dafür wollte ich jetzt auch kein Abo abschließen – und eigentlich (im Verlauf meiner Überlegungen) auch nicht länger die Datenhoheit über meine eigene Hörhistorie abgeben. Vorab: Ich verstehe last.fm. Vibecoding sei Dank hat die Last auf die Server, die schiere Datenmenge enorm zugenommen. All das sellt last.fm all seinen Benutzern schon immer kostenfrei zur Verfügung. Das hat sich wahrscheinlich nie so richtig getragen, aber jetzt, wo auch alle Ressourcen immer knapper werden, noch weniger. Und deshalb sieht sich last.fm zu diesem drastischen Schritt genötigt: Schnitt aller kostenlosen Nutznießer. Und deshalb würde ich die Gelegenheit nutzen, fortan nach einer Alternative zu suchen.
Und so habe ich angefangen zu recherchieren. Dieser Beitrag versteht sich als die Begleitung dessen. Und da stehe ich immer noch mit Pfotenhauer in Kontakt, wie weit er ist, ob der Import klappt, wie der Status ist. Und ich habs nebenbei aufgeschrieben. Baut das gern nach. Unser Freund Piehnat sucht z.B. auch noch nach einer Lösung.
Was Last.fm für mich war
Last.fm war lange ein stiller Begleiter. Man hört Musik, irgendein Player schickt sie an Last.fm, und Jahre später kann man nachschauen, was man wann gehört hat. Dazu gab es eine öffentliche API: aktueller Song, letzte Songs, was war am meisten, was ging letztes Jahr am besten, all time: alles ohne großes Bohei oder Brimborium.
Aber so geht es aus oben beschrieben Gründe nicht weiter. Die API wird kostenpflichtig, und wer nur ein Widget oder eine kleine Auswertung braucht, schaut in die Röhre. Oder zahlt. Das habe ich mir auch kurz überleght. Aber da der Trend, wie damals diese Do-It-Yourself-Attitüde des Punk, selbermachen, in einer andere Richtung zeigt, ist die Befreiung aus dem kommerziellen Silo dem man ausgeliefert ist, sinnvoller. Die eigene Hörhistorie liegt quasi bei einem Unternehmen, das sie jederzeit hinter eine Bezahlschranke legen kann. Und ja, so…
Was ich eigentlich brauche
So groß ist der Anspruch gar nicht:
- Scrobbeln von Navidrome und TerminalDrome – meinem selbstgehosteten Musikserver.
- Scrobbeln von Spotify
- Die komplette Historie jetzt auf was neues importieren – seit 2008, ohne Lücken.
- Den aktuellen oder zuletzt gespielten Song anzeigen – im Footer dieses Blogs und auf meinen anderen Websites, ich mag das sehr (ist aber natürlich nur eine Spielerei).
- Den Verlauf nachschauen – am liebsten jetzt in einer Oberfläche, die (bei) mir (ist) gehört.
Ich habe nicht damit gerechnet, weil das ja schon eine ziemlich Niesche ist und ich gar nicht so viele Leute kenne, die noch scrobblen. Aber zum Glück gibt es inzwischen eine ganze Reihe offener Projekte, die genau diese Nische abdecken.
Die Recherche: vier Projekte, ein Plan
Ich habe mir mehrere Kandidaten angeschaut. Die wichtigsten:
ListenBrainz
ListenBrainz ist so etwas wie der offene Gegenentwurf zu Last.fm: von der MetaBrainz Foundation betrieben, offene API, offene Daten, keine Werbung. Es kann Scrobbles von vielen Playern annehmen und hat eine schöne Statistik-Oberfläche.
Für mich war ListenBrainz lange die naheliegende Wahl. Aber: Der Spotify-Import läuft über Polling und ist nicht wirklich live, der Last.fm-Importer war 2026 zeitweise wackelig und brach jetzt dfast komplett zusammen, klar, unter der Last der vielen Wechsler, Pfotenhauer und ich sind nicht die einzigen, und ich wollte meine Historie am Ende nicht wieder bei einem Dienst abladen, der von der Gnade einer anderen API abhängt. ListenBrainz ist bei mir deshalb nicht verschwunden – es bleibt als öffentlicher Spiegel und Backup in der Kette. Die Datenbank gehört aber nicht mehr dort.
Libre.fm
Die freie Alternative. Sympathisch, aber für meinen Anwendungsfall nicht mehr zeitgemäß: Die Oberfläche ist in die Jahre gekommen, die Entwicklung stockt, und die Integration mit modernen Playern ist überschaubar. Als Backup nett, als Zentrale nicht.
Maloja
Maloja ist ein selbstgehosteter Scrobbler mit eigener Datenbank und sehr schönen Auswertungen. Technisch spannend, aber es zieht ein eigenes Ökosystem nach sich: eigene Importer, eigene Clients, eigene Konventionen. Wenn man schon Navidrome und Spotify hat, ist das ein weiterer Umzug.
Koito
Koito ist ein moderner, selbstgehosteter Scrobbler. Das Schöne: Er spricht die ListenBrainz-API. Alles, was nach ListenBrainz scrobbeln kann – Navidrome, viele Player, Web-Scrobbler, Spotify, Deezer – kann stattdessen nach Koito schreiben. Koito speichert in SQLite, hat eine hübsche Oberfläche, kann Last.fm-, Spotify-, ListenBrainz- und Maloja-Exporte importieren und kann alles zusätzlich an einen anderen ListenBrainz-kompatiblen Server weiterreichen.
Das war der Moment, in dem ich dachte: Das ist die Datenbank, die ich will.
Multi-Scrobbler
Multi-Scrobbler ist kein Scrobbler im engeren Sinne, sondern ein Hub: Er beobachtet viele Quellen – Spotify, Navidrome/Subsonic, Jellyfin, Plex, Bandcamp über Web-Scrobbler – und schickt die Plays an einen oder mehrere Clients. Dazu kennt er Now-Playing, Dedupe, Retries und ein öffentliches Dashboard.
Für mich ist Multi-Scrobbler der Adapter zwischen der lauten Welt der Streamingdienste und meiner Koito-Datenbank. Vor allem kann man so auch mit einem Firefox Web-Scrobbling Plugin von Sites wie Youtube oder vor allem Bandcamp scrobblen.
Die Architektur
Am Ende sieht es so aus:
Navidrome      ──(Subsonic-API)──┐
Spotify        ──(Spotify-API)───┼──> MS ──> Koito ──> LB
Web Scrobbler  ──(Webhook)───────┘
(MS = MultiScrobbler, LB = ListenBrainz)
- Koito ist die Datenbank und die Oberfläche. Hier liegt die Historie, hier schaue ich nach, hierher zeigt das Widget.
- Multi-Scrobbler ist der Eingang. Er holt Spotify und Navidrome ab und schreibt nach Koito.
- Navidrome könnte auch direkt nach Koito scrobbeln. Ich habe es trotzdem über Multi-Scrobbler laufen lassen, weil ich Now-Playing und Dashboard an einer Stelle haben wollte – und weil dann alle Quellen denselben Weg nehmen.
- ListenBrainz bleibt als öffentlicher Spiegel. Koito reicht alles dorthin weiter.
Der wichtigste Grundsatz: Ein Weg pro Quelle. Zwei parallele Scrobble-Pfade in dieselbe Datenbank erzeugen Dubletten, weil die Zeitstempel minimal abweichen.
Das How-to
Das Folgende ist die Einrichtung, wie ich sie bei mir laufen habe – auf einem Raspberry Pi, mit Docker und Caddy. Die Domainnamen sind Platzhalter; bei mir heißen sie scrobble.janmontag.de und ms.janmontag.de.
0. Voraussetzungen
- Ein Linux-Server (bei mir ein Pi5) mit Docker und Docker Compose
- Zwei (Sub-)Domains, die auf den Server zeigen
- Caddy als Reverse Proxy (oder nginx/Traefik, dann die Config entsprechend anpassen)
- Navidrome und ein Spotify-Konto
- Etwas Geduld für den Import, bei mir so 2 Tage, bei Pfotenhauer 6
1. Verzeichnis und Konfiguration
sudo mkdir -p /opt/scrobble/koito/import /opt/scrobble/ms
sudo chown -R "$USER":"$USER" /opt/scrobble
cd /opt/scrobble
Die zentrale .env:
cat > .env <<'EOF'
TZ=Europe/Berlin

# Koito
KOITO_DEFAULT_USERNAME=admin
KOITO_DEFAULT_PASSWORD=<starkes-passwort>
KOITO_BASE_URL=https://scrobble.example.com
KOITO_CORS_ALLOWED_ORIGINS=https://blog.example.com

# Multi-Scrobbler
ADMIN_SETUP_USER=admin
ADMIN_SETUP_PW=<starkes-passwort>
BASE_URL=https://ms.example.com

# wird nach dem ersten Start ergänzt
KOITO_API_KEY=
EOF
chmod 600 .env
2. Koito und Multi-Scrobbler starten
compose.yaml:
services:
  koito:
    image: gabehf/koito:latest
    container_name: koito
    restart: unless-stopped
    env_file: .env
    ports:
      - "127.0.0.1:4110:4110"
    volumes:
      - ./koito:/etc/koito

  multi-scrobbler:
    image: foxxmd/multi-scrobbler:latest
    container_name: multi-scrobbler
    restart: unless-stopped
    depends_on:
      - koito
    env_file: .env
    environment:
      BASE_URL: https://ms.example.com
      KOITO_ID: koito
      KOITO_URL: http://koito:4110
      KOITO_USER: admin
      KOITO_TOKEN: ${KOITO_API_KEY}
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "127.0.0.1:9078:9078"
    volumes:
      - ./ms:/config
Erst einmal nur Koito starten:
docker compose up -d koito
docker compose logs -f koito
3. HTTPS mit Caddy
scrobble.example.com {
    encode zstd gzip
    reverse_proxy 127.0.0.1:4110
}

ms.example.com {
    encode zstd gzip
    reverse_proxy 127.0.0.1:9078
}
Wichtig: eigene Subdomain für Multi-Scrobbler, kein Unterpfad. Ich hatte es zuerst unter /ms versucht; der OAuth-Callback von Spotify landet dann an der falschen Stelle. Mit einer eigenen Subdomain gibt es das Problem nicht.
sudo caddy validate --config /etc/caddy/Caddyfile
sudo systemctl reload caddy
4. Koito einrichten
https://scrobble.example.com öffnen, mit admin und dem Passwort aus der .env anmelden. Passwort ändern, dann unter Settings → API Keys einen Key anlegen.
Diesen Key in die .env eintragen:
sed -i 's|^KOITO_API_KEY=.*|KOITO_API_KEY=<key>|' .env
docker compose up -d
Der Key ist gleichzeitig der Token, mit dem Navidrome und Multi-Scrobbler nach Koito schreiben. Er ist ein Schreib-Token – bitte nicht veröffentlichen.
5. Spotify anbinden
- https://developer.spotify.com/dashboard → Create app
- Redirect URI:
https://ms.example.com/callback - Client ID und Secret kopieren
In die .env:
SPOTIFY_ID=spotify
SPOTIFY_CLIENT_ID=<client-id>
SPOTIFY_CLIENT_SECRET=<client-secret>
SPOTIFY_REDIRECT_URI=https://ms.example.com/callback
docker compose up -d
Dann https://ms.example.com öffnen, anmelden und auf der Spotify-Karte Authenticate klicken.
Zwei Dinge, die man wissen sollte: Spotify verlangt ein Premium-Konto, und die Verbindung läuft seit Juli 2026 nach sechs Monaten ab. Dann muss man sie einmal neu bestätigen.
6. Navidrome anbinden
Es gibt zwei Wege.
Variante A – direkt: Navidrome kann selbst nach ListenBrainz (und damit nach Koito) scrobbeln. In navidrome.toml:
ListenBrainz.Enabled = "true"
ListenBrainz.BaseURL = "https://scrobble.example.com/apis/listenbrainz/1"
Danach in Navidrome unter Personal → Scrobble to ListenBrainz den Koito-API-Key eintragen. Fertig.
Variante B – über Multi-Scrobbler: Das ist mein Setup. Multi-Scrobbler fragt Navidrome über die Subsonic-API ab und kennt dadurch auch das Now-Playing. Dafür lege ich einen eigenen, nicht-admin User an:
sudo systemctl stop navidrome
/opt/navidrome/navidrome user create \
  -c /var/lib/navidrome/navidrome.toml \
  -u scrobble --name "Scrobble Service" --library-ids 1
sudo systemctl start navidrome
Das Kommando fragt nach einem Passwort. Der Pfad zur Navidrome-Binary kann je nach Installation abweichen. Danach in die .env:
SUBSONIC_ID=navidrome
SUBSONIC_URL=http://host.docker.internal:4533
SUBSONIC_USER=scrobble
SUBSONIC_PASSWORD=<passwort>
extra_hosts in der Compose-Datei sorgt dafür, dass der Container den Host erreicht. Dann:
docker compose up -d
Wichtig: Wenn man Variante B nimmt, muss man in Navidrome das direkte ListenBrainz-Scrobbling abschalten (Personal → Scrobble to ListenBrainz aus). Sonst schreiben beide Wege dieselben Plays nach Koito, und man bekommt Dubletten.
7. Die Last.fm-Historie importieren
Den Export bekommt man über den Export von lastfm.ghan.nl als JSON (oder CSV). Die JSON-Datei muss im Namen recenttracks enthalten und nach koito/import/:
cp recenttracks-<user>.json /opt/scrobble/koito/import/
docker compose restart koito
docker compose logs -f koito
Koito erkennt den Last.fm-Export beim Start und importiert ihn im Hintergrund. Bei großen Mengen dauert das – MusicBrainz wird auf eine Anfrage pro Sekunde gedrosselt, und Koito reichert die Tracks dabei an. Bei mir waren es über 100.000 Einträge und am Ende mehr als ein Tag. Die Oberfläche bleibt währenddessen benutzbar, die Last auf der CPU ist eigentlich verschwindend gering, es sind andere Mitspieler die den Import so “langsam” machen. Am Ende bin ich froh, dass es überhaupt so einen entspannten Weg gibt.
Fortschritt:
sudo sqlite3 /opt/scrobble/koito/koito.db \
  "select count(*) from listens;"
sudo sqlite3 /opt/scrobble/koito/koito.db \
  "select datetime(min(listened_at),'unixepoch','localtime') from listens;"
Das zweite Kommando zeigt, wie weit der Import zurückgewandert ist. Bei mir ging es von 2026 bis zum 8. April 2008 – dem ersten Scrobble.
Dubletten: Der Last.fm-Export enthält gelegentlich denselben Track mehrfach innerhalb weniger Sekunden. Das sind Doppelübermittlungen des Scrobblers, keine echten Wiederholungen. Wahrscheinlich, wenn ich damals mehrfach auf den Song geklickt hab und er jedes mal als neuer Scrobble übertragen wurde. Vor über 12 Jahren oder sowas. Koito speichert sie wegen der abweichenden Zeitstempel als separate Listens. Ein kleiner Dedupe-Lauf räumt sie auf wenn man mag:
WITH x AS (
  SELECT l.rowid AS rid, l.listened_at,
         LAG(l.listened_at) OVER (
           PARTITION BY l.track_id ORDER BY l.listened_at
         ) AS prev
  FROM listens l
)
DELETE FROM listens
WHERE rowid IN (
  SELECT rid FROM x
  WHERE prev IS NOT NULL AND listened_at - prev <= 10
);
Bei mir waren das am Ende rund 15.000 Einträge. Danach ist die Historie ein bisschen kleiner, aber aufgeräumt – und die Minutenstatistik stimmt eher.
8. Bandcamp und andere Websites
Für Bandcamp, YouTube Music und ähnliche Seiten gibt es die Browser-Erweiterung Web Scrobbler. Sie kann ihre Scrobbles per Webhook an Multi-Scrobbler schicken:
- Erweiterung → Accounts → Add Webhook
- API URL:
https://ms.example.com/api/webscrobbler
Der Endpunkt ist bewusst offen, damit die Erweiterung ohne Login schreiben kann. Wer die URL kennt, könnte theoretisch Müll einschicken; für ein privates Setup ist das ein überschaubares Risiko.
9. Das Widget für die Website
Koito hat eine öffentliche Lese-API. Für den Footer reichen zwei Aufrufe:
curl https://scrobble.example.com/apis/web/v1/now-playing
curl "https://scrobble.example.com/apis/web/v1/listens?limit=1&period=all_time"
Damit der Browser der eigenen Website zugreifen darf, muss die Origin in der .env stehen:
KOITO_CORS_ALLOWED_ORIGINS=https://blog.example.com
Ein minimales Widget:
const KOITO = 'https://scrobble.example.com';

async function updateWidget() {
  const np = await fetch(KOITO + '/apis/web/v1/now-playing').then(r => r.json());

  if (np.currently_playing) {
    const t = np.track;
    console.log('läuft gerade:', t.title, t.artists.map(a => a.name).join(', '));
    return;
  }

  const last = await fetch(
    KOITO + '/apis/web/v1/listens?limit=1&period=all_time'
  ).then(r => r.json());

  const item = last.items && last.items[0];
  if (item) {
    console.log('zuletzt:', item.track.title, item.time);
  }
}

updateWidget();
setInterval(updateWidget, 30000);
Zwei Stolperfallen: Das period=all_time ist nötig, sonst liefert die Listens-API nichts. Und die Bild-URLs sind relativ – man muss https://scrobble.example.com davorschreiben.
10. Backups, Sicherheit und Fallstricke
.envmitchmod 600schützen. Der Koito-Key ist ein Schreib-Token.- Backups:
koito/koito.db, derms/-Ordner und die Navidrome-Datenbank reichen für den Anfang. - Spotify: Alle sechs Monate neu authentifizieren.
- Ein Weg pro Quelle: Entweder Navidrome direkt oder über Multi-Scrobbler, nicht beides.
- Zeitstempel: Koito speichert den Start eines Tracks, Last.fm den Scrobble-Zeitpunkt (meist am Ende). Deshalb sehen die „letzten 10“ bei einem Vergleich leicht anders aus – das ist kein Datenverlust, sondern eine andere Zeitbasis.
- Import geduldig laufen lassen. Der MusicBrainz-Lookup ist der Flaschenhals, nicht die Datenbank.
Was am Ende dabei herauskommt
Ein Footer-Widget, das ich auch über den 01.12.2026 benutzen kann. Eine Historie, die weiterhin nach 2008 zurückreicht. Eine Oberfläche unter meiner eigenen Domain, in der ich nachschauen kann, was ich wann gehört habe. Und mein Setup, nicht eine API, die vielleicht jemand abschaltet.
Die Daten liegen in einer SQLite-Datei, die ich sehr einfach sichern kann. Die Software ist überdies offen. Wenn Koito morgen nicht mehr weiterentwickelt würde, könnte ich die Daten mitnehmen. Das ist immer ein wichtiges Argument bei digitaler Souveränität.
Fazit
Last.fm war ein gutes Stück Infrastruktur, aber die Zeiten ändern sich. Offensichtlich ist es jetzt Zeit geworden, zu gehn. Mit Koito als Datenbank und Multi-Scrobbler als Eingang kann man etwas bauen, das (den) meinen Alltag abdeckt: Navidrome, Spotify, Bandcamp, alles landet in Koito als Schaltzentralle und Speicher und das Widget im Footer fragt einfach meine eigene Instanz.
Warnung
Der Weg dahin war nicht kompliziert, aber er hatte ein paar Ecken: der Unterpfad-Bug bei Multi-Scrobbler, die Geduld beim Import, die Dubletten im Last.fm-Export. Wenn man diese drei kennt, ist der Rest erstaunlich unspektakulär.
Und der erste Eintrag ist immer noch da: Funny van Dannen – Lobdefizit, 8. April 2008, 22:35 Uhr.